
当代码大模型从“写出一段代码”走向“完成一项工程任务”,一个新的问题摆在软件产业面前:模型会写代码,是否意味着它能够胜任真实的软件工程?生成一段正确的代码,与理解一个运行多年的复杂系统、准确修改相互依赖的程序、定位缺陷并完成测试,并不是同一回事。
当AI开始深入软件研发流程,产业需要的不再只是更高的模型分数,还需要回答更实际的问题:模型能否完成真实任务?结果是否具备工程价值?在复杂环境中能否保持稳定、可控?代码能力的评价标准,正在向真实软件工程延伸。
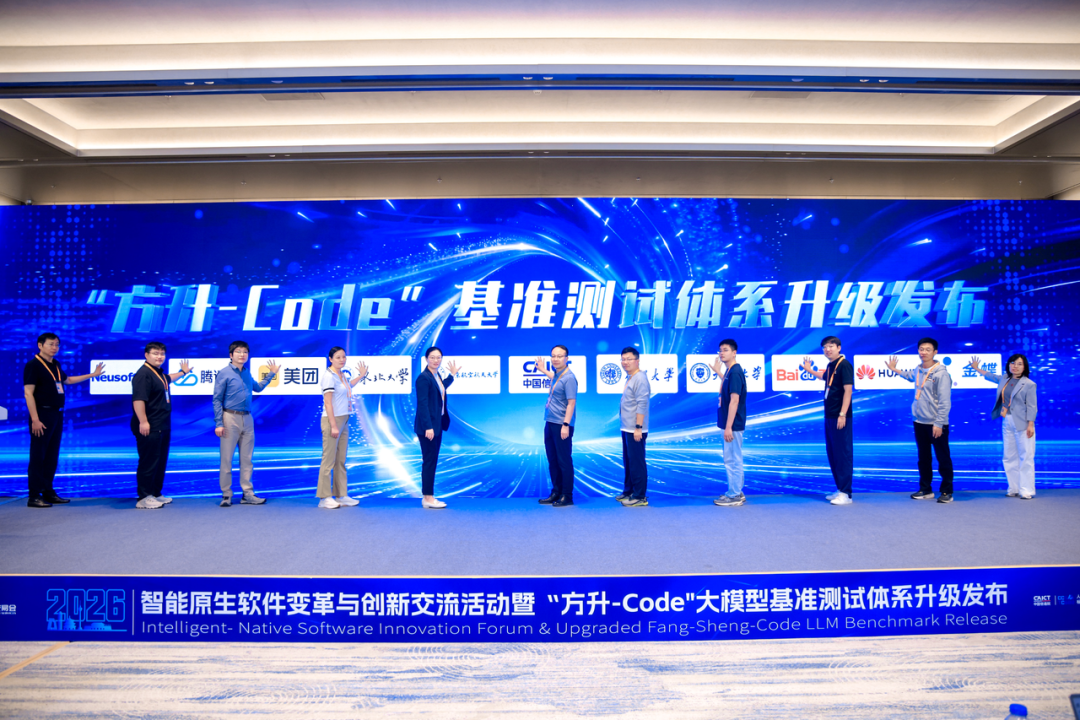
2026年中国国际服务贸易交易会期间,“智能原生软件变革与创新交流活动暨‘方升-Code’大模型基准测试体系升级发布”在北京首钢园举行。活动围绕代码大模型能力评测、智能原生软件前沿实践及AI+软件工程创新等议题展开,集中发布了“方升-Code”大模型代码能力基准测试体系升级成果、2026AI+软件“银弹”优秀实践、首批“AI+软件”评估结果等多项成果。
东软集团通信事业部受邀出席。事业部副总经理孙毅夫代表东软参与“方升-Code”大模型代码能力基准测试体系升级发布,并参加同期举行的闭门研讨,与科研机构、高校及产业代表共同探讨面向真实软件工程的代码能力评价。
对长期从事大型软件工程的东软而言,这一议题具有明确的实践意义:评价代码大模型,不仅要看它能生成什么,更要看它能否在复杂系统中把事情做对。
从代码正确率,走向真实工程能力
代码大模型正在承担越来越复杂的任务。从代码生成与补全,到理解已有代码、解决程序问题、生成单元测试,再到以Agent形态执行更长的工程任务,AI参与软件研发的范围不断扩大。任务发生变化,评价方法也需要相应改变。
一段代码能够通过测试,并不意味着模型理解了整个系统;一次任务成功,也不足以证明它能够在不同环境和复杂约束下保持稳定。对于企业而言,技术选型与工程部署需要回答一组更具体的问题:模型能否准确理解任务?生成结果是否满足工程要求?能否形成有效测试?执行过程是否稳定?完成任务需要多少时间与成本?这些问题,已经超出单一代码正确率所能反映的范围。
“方升-Code”大模型代码能力基准测试体系正是在这一背景下持续演进。根据本次活动发布的相关内容,升级后的体系进一步面向真实软件工程,形成覆盖代码生成、代码问题解决、单元测试、研发问答等典型任务的多任务评测数据,并通过动态测试与难度分级,增强对模型能力差异的识别。
在评价维度上,体系进一步关注工程质量、实际价值、效率成本、任务过程和能力稳定性,使评价视角更加贴近企业研发与生产的实际需求。这意味着,评测不仅关注模型能否给出答案,还要进一步观察答案能否形成可靠、具有工程价值的结果。
代码大模型的价值,最终要接受真实软件工程的检验。
大型软件工程
为代码能力提出了更难的问题
评测体系的升级,需要回答“应该评什么”。来自产业一线的工程实践,则能够帮助识别:哪些问题最值得纳入评价?在同期举行的“方升-Code”大模型代码能力基准测试闭门研讨中,与会代表围绕重点评测方向、科学评测方法、评测如何反哺研发,以及AGI时代评测体系演进和国际影响力提升等议题展开交流。
东软结合长期大型软件工程与通信行业实践,参与了相关讨论。对于持续运行多年、规模庞大、依赖关系复杂的核心生产系统,软件研发的难点,往往不在于从零写出一段代码,而在于理解和改变一个已经存在的复杂系统。工程师需要读懂历史代码,识别模块之间的依赖,定位问题,并在不破坏已有功能的前提下完成修改。一项看似局部的需求,可能涉及多个文件、复杂调用关系和长期积累的业务规则。代码修改完成,也不意味着工程任务已经结束,还需要通过测试验证结果,并处理执行过程中可能出现的异常。
这些真实场景,对代码大模型提出了更高要求:
系统理解:能否理解大型代码仓及其依赖关系?
任务执行:能否完成跨文件修改与缺陷修复?质量保障:能否生成有效测试,识别修改引入的风险?稳定可控:当任务变长、环境变化或执行异常时,能否可靠地完成任务?如果评测主要关注相对独立的代码生成,就难以完整反映模型应对上述工程挑战的能力。
围绕这些问题,东软在研讨中建议,进一步强化真实任务结构、场景化题库和应用侧验证,让评测任务与实际研发需求建立更紧密的联系。在测试数据方面,可探索通过脱敏与合成数据兼顾工程真实性与测试可复现性;在任务设计方面,应进一步关注异常恢复、安全边界和长程任务执行能力。这些建议的重点,不是单纯增加测试题目,而是让评测更加贴近软件工程的真实工作方式。
让模型在评测中面对的问题,更接近工程师每天真正需要解决的问题。对于软件企业而言,评测任务与真实研发场景建立的联系越紧密,测试结果就越有机会为模型选择、工程部署和持续优化提供有价值的参考。
从模型榜单
走向产业应用的共同语言
一套基准测试体系的价值,不应止于形成模型榜单。当代码大模型进入软件研发核心流程,评测还需要连接模型研发与企业应用,让双方能够围绕相对一致的评价依据展开交流。对于模型研发者,评测能够帮助识别能力短板,检验模型迭代效果。对于软件企业,评测能够为技术选型提供参考,帮助判断不同模型在特定任务、技术栈和工程约束下的适配性。对于整个产业,持续演进的评测体系则有助于把真实应用需求转化为可描述、可比较、可验证的评价问题。
这也是“方升-Code”评测体系升级所具有的产业意义:推动代码能力评价进一步连接模型研发与软件生产。但通用评测不能代替企业自身的场景验证。模型在基准任务中表现良好,并不代表它适用于所有业务系统。尤其对于承担关键业务的复杂软件,企业仍需要结合自身的代码环境、业务规则和风险要求,检验模型的适用条件与能力边界。
评测帮助企业认识模型的能力,场景验证帮助企业判断模型能否真正投入使用。两者相互补充,才能使能力评价更好地服务工程实践。对东软而言,参与此次升级发布与研讨,也是将大型软件工程实践中的需求和经验带入产业交流的一次机会。未来,东软期待继续结合大型软件工程与通信行业实践,与中国信通院及产业伙伴围绕评测场景、任务模型和应用验证等方向开展交流,共同探索更贴近真实研发、更服务生产应用的代码能力评价方式。
当AI开始参与创造软件,衡量AI的标准,也必须深入软件工程。
 海量资讯、精准解读,尽在新浪财经APP
红腾网配资提示:文章来自网络,不代表本站观点。


